Páginas

SyntaxHighlighter

Mostrando postagens com marcador continuous integration. Mostrar todas as postagens

quarta-feira, 5 de março de 2014

Hooking Bitbucket up with Jenkins parameterized jobs

Bitbucket repositories allow us to setup hooks which notify/trigger Jenkins' jobs about newly pushed code. The process to create such a hook is documented here. However, it doesn't mention how to integrate with Jenkins parameterized jobs.
After reading the Jenkins documentation and a few trial and error I managed integrate Bitbucket and Jenkins parameterized jobs.
The hook management form presents 4 fields:

  1. Endpoint: Here, you’ll need to set your Jenkins URL in the following format — http://username:apitoken@your.jenkins.url/job/your.job.name/buildWithParameters 
  2. Module name: (Optional)
  3. Project name: (Leave Empty)
  4. Token: It’s the authentication token you defined in your Jenkins job settings 

The gotcha is leaving the project name field blank and include it in the endpoint URL appended with buildWithParameters.


sábado, 10 de novembro de 2012

Setting up Jenkins on EC2 using AWS CloudFormation (including nginx as a reverse proxy)

I lost count on how many times I had to setup a CI server. Being a big fan of the concept of "Infrastructure as Code" as I am, I promised myself that the next time I'd do it differently (I needed to have it automated!).

Well, the day has come.The stack (using Cloudformation terms) I decided to create is composed by a basic Jenkins installation (standalone + winstone) running as a daemon on an Amazon Linux based EC2 intance. It also includes Nginx as a reverse proxy and a dedicated volume for storing the JENKINS_HOME files and other artifacts.

Obviously that a much easier, simpler and (I think) even cheaper alternative would be using some PaaS offering (Jenkins as a Service).

However, I ended up using AWS Cloudformation to automate the provisioning of the AWS Resources (IAM User, SecurityGroup, EBS Volumes, EC2 instance) and its cloud-init features to install and configure the necessary packages.

External repository addition, yum based package installations, configuration files adjustments, EBS volumes setup, etc. Most of the installation and configuration logic is in a shell script embedded in the UserData property.

The resulting template is right below, the input parameters are: Instance type, JENKINS_HOME volume size in gigabytes and the EC2 KeyName. The output is the Jenkins server URL!

Loading ....


terça-feira, 11 de outubro de 2011

Automating GAE's application deployment with Jenkins

Follow below the expect script I created to automate the deployment of applications on GAE. It simply invokes/spawns the appcfg.sh and sends the account's password when prompted.
Then I configured a Jenkins job which contains a "execute shell" step invoking this script.

Jenkins "execute shell" step

expect $WORKSPACE/appcfg.exp "$APPENGINE_HOME" "myuser@gmail.com" "mypassword" "update" "$WORKSPACE/war"

appcfg.exp expect script

#!/usr/bin/expect -f
# Expect script to supply GAE's account password for appcfg.sh
#
# This script needs four arguments:
# username = GAE's google account email
# password = GAE's google account password
# warDir = war directory to deploy to GAE
# gaeHome = GAE's SDK home dir
#
# For example:
#  expect appcfg.exp myemail@gmail.com mypassword ./war /usr/share/appengine-sdk-1.5.3

if {[llength $argv] == 0} {
   puts "usage: appcfg.exp {-index|#}"
   exit 1
}

set gaeHome [lrange $argv 0 0]
set username [lrange $argv 1 1]
set password [lrange $argv 2 2]
set cmd [lrange $argv 3 3]
set warDir [lrange $argv 4 4]

set timeout -1

# spawns appcfg.sh
spawn $gaeHome/bin/appcfg.sh --enable_jar_splitting --passin --email=$username $cmd $warDir
match_max 100000

expect {
   default {exit 0}
   # Look for passwod prompt
   "*?assword*"
}

# Send password aka $password
send -- "$password\r"

# send blank line (\r) to make sure we get back to gui
send -- "\r"
expect eof

Using XmlSlurper to update appengine-web.xml

I'm currently working on a project which is using GAE (Google Application Engine).
I wanted to setup Jenkins' jobs to update the different stages (acceptance, qa, uat) in our build pipeline.
To achieve that I created 3 different GAE's applications - one for each stage - and 4 Jenkins jobs: 1 template which holds the common steps and 3 others for the respective stages.
The first step of the template job updates appengine-web.xml target application and version based on parameters passed to the job.


See the groovy script below:


import groovy.xml.StreamingMarkupBuilder

//getting parameters values from environment variables
def env = System.getenv()
def workspace = env["WORKSPACE"]
def applicationName = env["TARGET_APPLICATION_NAME"]
def versionName = env["TARGET_VERSION_NAME"]
def ant = new AntBuilder()
ant.echo(message:"Opening $workspace/war/WEB-INF/appengine-web.xml")
def file = new File("$workspace/war/WEB-INF/appengine-web.xml")
def root = new XmlSlurper().parse(file)
ant.echo(message:"Updating appengine-web.xml with application: $applicationName and version: $versionName")
root.application=applicationName
root.version=versionName 
def outputBuilder = new StreamingMarkupBuilder()
String result = outputBuilder.bind{ 
   mkp.declareNamespace("":  "http://appengine.google.com/ns/1.0")    
   mkp.yield root 
}
ant.echo(message:"Writing appengine-web.xml")
file.write(result)

terça-feira, 9 de novembro de 2010

A arte de desenvolver sem branches

Ultimamente eu e meu time estamos evitando ao máximo a criação de branches no SVN. Nosso objetivo é comitar apenas no trunk e tentar manter a aplicação sempre releaseable. Acreditamos que isso ajuda a manter o fluxo de entregas constante e o caminho aberto para o sonhado continuous deployment e delivery.

Nossas últimas experiências com feature branch foram desagradáveis. Além dos (muito) chatos, às vezes longos, e arriscados merges envolvidos na criação de um novo branch, o que mais incomoda é a falta de integração contínua e o "tumulto" causado quando o branch é reintegrado ao trunk - dependendo do tamanho e o grau de intrusão é necessária uma longa fase de estabilização.

Para evitar esse transtorno, uma prática que começamos a adotar é, ao invés de criar branches no controlador de versão, fazer as ramificações no próprio código fonte - branch by abstraction. Basicamente o que fazemos é criar flags em arquivos de propriedades da aplicação e utilizá-las para esconder/desabilitar uma feature incompleta (GUI) ou para chavear entre uma implementação ou outra.

Características do design, por exemplo utilização de patterns como  Dependency Injection, Strategy e Factory, facilitam bastante o trabalho. Mais que isso, já vi casos de refactorings para suportar esse tipo de chaveamento, melhorar o design através da redução do acoplamento, e nascimento de novos componentes!

É uma estratégia bem simples de adotar e que traz alguns benefícios. Como continuamos a comitar no mainline, o código segue sendo continuamente integrado pelo Hudson juntamente com as demais features. Se bem planejado e estruturado, é possível entregar a feature aos poucos, em pequenas partes, reduzindo o risco das implantações. A cada release pouquíssimo código novo é implantado e consequentemente a identificação de eventuais bugs ou efeitos colaterais indesejados é antecipada, reduzindo o custo de investigação e correção.

Para ilustrar: suponha que temos uma nova demanda que alterará drasticamente o cerne da aplicação. Pior que isso, a estimativa para terminá-la é de alguns dias, podendo chegar até uma semana. Em paralelo várias outras melhorias e correções de bugs menores irão acontecer. O objetivo é entregar o quanto antes tudo o que for ficando pronto e evitar ao máximo o "represamento" de código.

Enxergo três opções: A primeira, e pior de todas, é sair implementando tudo no trunk deixando a aplicação unreleaseable por um longo período de tempo. A segunda é criar uma feature branch para a alteração maior e desenvolver as demandas menores no trunk, dessa forma conseguimos manter o ritmo de entregas, mas o código da alteração maior é "estocado". A última é criar um code flip, implementar todas as demandas no trunk só que deixando a grande alteração dormente e escondida. Apesar de incompleto e invisível para o usuário o código faz parte dos binários entregues, passou pela integração contínua e por QA - já está sendo aceito, está implantado!

Alguns pontos de atenção caso opte pela feature flag:
  • Aposentar os code flips e garantir a remoção do código obsoleto;
  • Manter ambos os caminhos (code paths) enquanto as duas versões coexistirem.
Volto a mencionar que esse tipo de decisão precisa ser bem pensada. Já tivemos períodos tensos com bloqueamento de implantações - tanto com branches normais como abstratas. Se seu cliente estiver "mal acostumado" com várias entregas por semana, por exemplo, e você começar a faze-lás quinzenalmente, pode ter certeza que ele vai reclamar. Além do que, a sensação de receber software concreto quase que diariamente, é mil vezes melhor que um "burndown na pinta".

É importante ressaltar que apesar do título, não estou dizendo que nunca criarei branches ou que é sempre melhor evitá-los. Sei que existem casos onde não há outra saída. O importante é saber tomar esse tipo de decisão - focar nas entregas mais frequentes.

Para se aprofundar melhor:

sábado, 17 de julho de 2010

Relato de um viciado em testes

No projeto onde trabalho há quase um ano a funcionalidade mais importante da aplicação é a habilidade de gerar Balanced Scorecards das diversas estruturas da empresa baseados em variados tipos de configurações, fórmulas, cargas de métricas e complexas regras de cálculos. Tudo isso parametrizável pelo usuário.
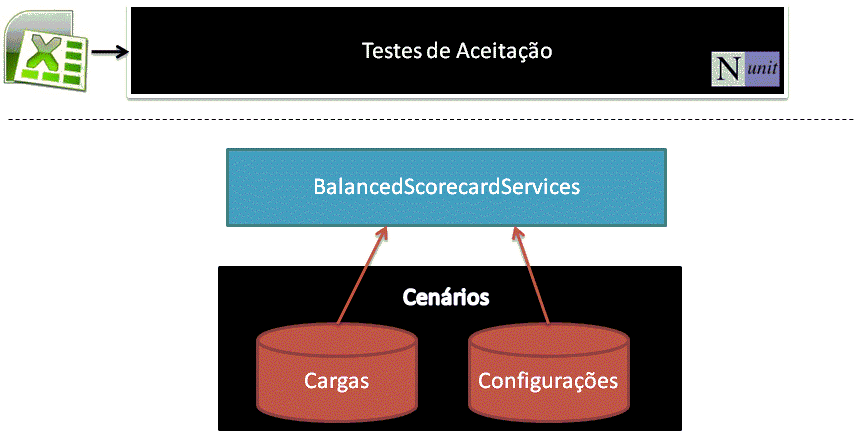
Para testar se esses BSCs estão sendo devidamente calculados: aplicação de parametrizações, interpretação de fórmulas, consolidações de indicadores, etc, criamos uma série de testes de aceitação que estressam diretamente o componente BalancedScorecardServices.

Como estruturamos nossa suíte?

Num primeiro momento cogitamos implementar essa suíte através da GUI, mas logo descartamos essa idéia devido as várias dependências que seriam criadas. Ficaríamos dependentes da aplicação estar implantada no servidor de aplicação (IIS) e pior que isso criaríamos uma possível amarração com o markup da tela - complexidades desnecessárias. Daí a decisão de estimularmos diretamente o componente de geração de BSCs - mesma interface utilizado pela GUI.


A manutenção da suiíte consiste em definir os parâmetros de entrada e os resultados esperados para cada cenário de teste numa planilha excel (criamos algumas extensões do Nunit que sabem ler essas planilhas e transformar cada uma das linhas num testcase). Além disso mantemos as configurações e cargas de métricas num banco de dados que completam os cenários cadastrados na planilha.


O servidor de integração contínua (Hudson) é automaticamente disparado à cada nova alteração no código, daí ele gera os binários, implanta no ambiente de testes de aceitação e roda a suíte de testes. Na ocorrência de qualquer erro ou falha todo time é notificado via build radiator e email.

Design Estratégico ou sorte do acaso?

Sorte nada, essa foi uma das decisões mais acertadas do nosso time. Desde a primeira versão desse componente (7 sprints atrás) optamos por investir um esforço extra na criação e automatização desse mecanismo de testes. Primeiro porque sabíamos que tratava-se do core da aplicação e que havia um alto grau de complexidade envolvido na geração e principalmente nos testes desses BSCs e segundo porque tínhamos uma visão bem clara do quanto ainda evoluiríamos esse módulo.

Percebemos também que somente testando os cálculos dessa forma teríamos condições de ter um ciclo de feedback mais rápido e preciso (suíte + CI). Só assim seríamos capazes de evoluir o componente e continuamente adicionar novas funcionalidades com mais segurança.

Atualmente temos aproximadamente 200 cenários diferentes de testes que são executados no mínimo 10 vezes por dia. Imaginem o tempo que gastaríamos se os testes fossem feitos manualmente via GUI?

Confiança, tranquilidade, agilidade, qualidade...

Confiamos cegamente nessa suíte. Até agora, tivémos no mínimo quatro grandes refactorings nesse componente e outros estão por vir. Ora por questões de performance, ora por adição de novas funcionalidades ou correção de defeitos. É muito bom poder mexer à vontade no código, reestruturá-lo, virá-lo de cabeça pra baixo daí apertar um botão e, se tudo estiver verde, ter certeza que tudo continua funcionando como antes.
Tem sido uma ótima experiência e certamente continuarei utilizando esse tipo de abordagem em projetos futuros.

Segue a dica então. Fiquem atentos aos componente críticos e invista, sem medo, numa suíte de testes de aceitação automatizados. Por mais difícil que possa parecer sempre há um jeito. Recomendo fortemente.

domingo, 31 de maio de 2009

Hudson CMVC plugin 0.1 released !!

Finalmente conseguimos estabilizar uma versão do plugin do CMVC para o Hudson. Já fizemos a release conforme havíamos prometido.
Apesar de obsoleto acredito que existam mais pessoas por aí que como eu, utilizam o CMVC no trabalho. Garanto que com esse plugin fica bem mais fácil montar um ambiente de integração contínua com o hudson qualquer que seja a plataforma - já estamos usando-o para buildar projetos .NET e JEE (maven2).
Façam bom proveito do plugin!

quinta-feira, 7 de maio de 2009

Plugin do CMVC para Hudson

Como já havia postado, eu e um amigo estamos fazendo um plugin do CMVC para o Hudson. Já estamos nos finalmentes.

Há alguns dias me tornei committer e ontem subi todos os últimos refactorings já no repositório do java.net. Comecei também a documentá-lo no Wiki do Hudson.

Mais alguns testes e teremos a primeira release!!

sexta-feira, 24 de abril de 2009

CMVC SCM plugin para Hudson

Comecei mais uma empreitada com o CMVC (um amigo meu tá dando uma força). Agora o objetivo é integrá-lo com o Hudson.

Já chegamos numa versão funcional (seguimos o tutorial do wiki). O que temos até agora:

  • Tela de configuração do CMVC, onde é definido caminho para os executáveis;
  • Interface para configuração de dados específicos de um job: family, release, become, etc.
O plugin já consegue conectar no servidor e verficar por tracks integradas e depois disparar a build. Por enquanto, para a execução do checkout, disparamos um script parametrizado.

Assim que chegarmos numa versão mais estável pretendemos subí-lo no repositório central.

E vqv...

quinta-feira, 23 de abril de 2009

Integrando o CMVC com o CruiseControl

Onde trabalho utilizamos o CMVC ( CM... o que?) como ferramenta de SCM. É uma ferramenta já descontinuada pela IBM, mas funciona muito bem e nos atende perfeitamente.

Um dos problemas que enfrentamos é a falta de suporte das ferramentas de integração contínua: CruiseControl, Hudson, Continuum, etc. Todas elas oferecem suporte/plugins para as ferramentas mais utilizadas como SVN, CVS, Clearcase, TeamSystem, etc, mas para o CMVC...

Então decidi dar uma estudada para saber a real complexidade de extender essas ferramentas.
Comecei pelo CruiseControl, pois era um servidor de integração contínua que conhecia melhor. Descobri que tinha que implementar apenas 2 interfaces. Como sempre acontece, não aguentei e botei a mão na massa!

Cheguei numa versão funcional. Anexei o patch no Jira do CruiseControl. Não sei se será aplicado, mas se alguém precisar... é só baixar lá!!